

Техническое SEO и индексация сайта: как ускорить попадание в поиск и избавиться от дублей
Техническое SEO и индексация сайта решаются тремя переменными: что краулер видит, как часто он возвращается и сколько ресурсов готов потратить на ваши URL. Всё остальное — тексты, семантика, ссылки — работает только после того, как эти три переменные приведены в порядок.
Содержимое:
За 20 лет в техническом SEO я разобрал несколько сотен проектов, и картина повторяется почти без исключений: сайт с сильным редакционным блоком и нормальной ссылочной базой годами не выходит из второго десятка, потому что краулер упирается в закрытую директорию в robots.txt либо тонет в параметрических дублях. В 2026 году поисковые системы расходуют обход жёстко экономно — и это единственная переменная, которую вы контролируете напрямую.
Дальше — только инструкции: рабочие шаблоны, лимиты, алгоритм поиска дублей, матрица «canonical или 301» и разбор кодов ответов. Воды про важность уникального текста здесь нет.
Что такое техническое SEO и почему без него контент не будет ранжироваться в 2026 году
Техническая оптимизация — это управление доступностью и стоимостью обхода. Не оптимизация «под алгоритм», а инженерная настройка того, как сервер отвечает боту, какие URL считаются основными и сколько запросов в секунду вы готовы отдать.
Три слоя технической оптимизации, без которых текст не работает
- Доступность: robots.txt, коды ответов, DNS, TLS, рендеринг. Если слой сломан — краулер не доходит до контента.
- Идентичность: canonical, 301, структура URL, иерархия разделов. Определяет, какой из десяти одинаковых URL получит вес.
- Экономика: краулинговый бюджет, скорость ответа, доля полезных URL в общей массе. Определяет, как быстро новые страницы появятся в выдаче.
Почему хороший контент не спасает закрытый от обхода раздел
Механика простая. Страница, закрытая директивой Disallow, не скачивается. Раз не скачана — не проанализирована, не просканирована на ссылки, не получила внутренних сигналов. Ссылки с такой страницы не передаются. В результате идеальный лонгрид в /blog/ не участвует в ранжировании, а раздел, который должен был тянутьcommercial-страницы вверх, остаётся пустым местом.
Обратная ситуация встречается чаще и заметнее хуже: раздел открыт, но содержит 40 000 URL, из которых уникальны 3 000. Краулер тратит лимит на мусор, и свежие документы появляются в выдаче через недели.
Что изменилось в 2026 году: экономный обход и приоритет здоровья сайта
Поисковые системы перераспределили ресурсы на обслуживание AI-инфраструктуры и ускорили обработку сигналов качества. Практические следствия для вебмастера:
- Скорость и стабильность ответа сервера напрямую определяют частоту возвращения бота.
- Доля пустых, тонких и дублирующих URL в общей массе сайта стала измеримым фактором: чем выше доля, тем реже краулер приходит за новым.
- Порог входа снизился, но порог удержания вырос: попасть в индекс легко, удержать позиции по конкурентным запросам — нет.
Любая редакционная работа обнуляется, если краулер не может получить страницу или получает её в десяти копиях. Поэтому аудит начинают не с текстов, а с логов сервера и выгрузки всех URL. Читайте еще: продвижение во ВКонтакте, актуальные алгоритмы.

Индексация сайта: как работают краулеры Яндекса и Google, что такое краулинговый бюджет
Индексация — это не одно действие, а конвейер из трёх стадий, и каждая может отвалиться отдельно.
Двухэтапная механика: обход, рендеринг, индексирование
- Обход (crawling): бот получает HTML по списку URL из внутренних ссылок, карты сайта, внешних упоминаний и своего расписания возвращения.
- Рендеринг: Google индексирует HTML сразу, а рендеринг JavaScript выполняет отдельным проходом — с задержкой от часов до нескольких дней. Страница, чей контент существует только после выполнения JS, попадает в индекс с задержкой и часто в усечённом виде. Яндекс рендерит аналогично, но сильнее зависит от скорости ответа.
- Индексирование и ранжирование: страница проходит фильтрацию по уникальности, полезности, соответствию интенту. Здесь отваливаются дубли и тонкие URL.
Отсюда базовое правило для SPA и гибридных шаблонов: критичный контент, заголовки, canonical, перелинковка должны быть в исходном HTML. Всё, что появляется только после выполнения JavaScript, индексируется с задержкой и без гарантий.
Из чего складывается краулинговый бюджет и как его посчитать
Бюджет — произведение двух величин:
- Crawl rate limit — сколько запросов в секунду поисковик готов делать к вашему хосту. Растёт при низком TTFB, отсутствии 5xx и стабильном ответе. Падает при таймаутах, ошибках и перегрузе сервера.
- Crawl demand — насколько поисковику нужны ваши URL. Определяется обновляемостью, плотностью внутренних ссылок, внешними упоминаниями и историей: как часто вы отдавали уникальный контент, а не пустые копии.
Расчёт на реальном кейсе. Каталог: 1 000 000 URL в выдаче по логам за месяц, из них уникальных товарных карточек — 120 000. По логам сервера 78% запросов краулера приходилось на /catalog/?price_from=…&sort=…&pagenum=…. После закрытия параметров от обхода, перевода пагинации на self-canonical и разрыва циклических ссылок «фильтр → фильтр» доля целевых карточек в обходе выросла с 22% до 71% за три недели, при том что сервер остался тем же.
Что сжигает бюджет в первую очередь
- Параметры сортировки, фильтрации, пагинации, внутренние поисковые выдачи, UTM-хвосты.
- Зеркала: http/https, www/без www, хвостовой слэш, которые отдают 200 вместо 301.
- Редиректные цепочки: каждый хоп — отдельный запрос с нулевой отдачей.
- Страницы со статусом 200 и контентом 404 (soft 404) — худший вариант: бот возвращается снова и снова.
- Закрытые в robots.txt, но оставленные в карте сайта URL: запросы делаются на карту, а обрыв обнаруживается позже.
- Открытые для обхода служебные разделы: /cart/, /checkout/, /personal/, /search?query=.
Как ускорить индексацию сайта в Яндексе: порядок действий
Работает не «пинг», а связка из четырёх элементов. В таком порядке:
- Карта сайта с честным lastmod — см. раздел 4. Это основной сигнал свежести.
- Внутренняя ссылка на новый URL с главной или из материнского раздела в момент публикации. По данным Google, подавляющее большинство новых URL обнаруживается по внутренним ссылкам, а не по карте: карта помогает обнаружению, но не заменяет ссылочную связность.
- Ручной переобход в Яндекс.Вебмастере: раздел «Индексирование» — добавление конкретных URL в очередь переобхода и настройка расписания. Инструмент точечный, годится для партий в десятки адресов, не для каталога на 100 000 позиций.
- Здоровье сервера: TTFB в пределах нормы и нулевая доля 5xx. Без этого три предыдущих пункта дают полэффекта.
В Google ручной запрос переиндексации в Search Console жёстко лимитирован и рассчитан на единичные страницы. Для массовых публикаций используйте WebSub (PubSubHubbub) — подтверждённый механизм мгновенного уведомления Google о свежем контенте в RSS/Atom, и корректный sitemap с меняющимся lastmod. Indexing API применим только к JobPosting и трансляциям; применение «для всего подряд» приводит к тому, что запросы начинают игнорировать.
Robots.txt: как правильно настроить файл (актуальный шаблон и список запрещенных директив)
Robots.txt — инструкция по обходу, а не по индексации. Файл лежит в корне хоста: https://example.com/robots.txt, отдаёт статус 200 и тип text/plain. Лимит: Google читает первые 500 KiB, всё сверх обрезается без предупреждения. Если файл отдаёт 404 или 500 — обход идёт без ограничений, но вы теряете управление.
Актуальный шаблон robots.txt на 2026 год
# robots.txt — шаблон 2026. Корень домена, статус 200, размер < 500 KiB.
# Правило группировки: более специфичный User-agent ставится ВЫШЕ,
# User-agent: * — в конце. Google применяет первую совпавшую группу.
# --- Google ---
User-agent: Googlebot
Disallow: /cart/
Disallow: /checkout/
Disallow: /personal/
Disallow: /admin/
Disallow: /api/
Disallow: /search?
Disallow: /*?utm_
Disallow: /*?sort_by=
Disallow: /*?price_from=
Disallow: /*?replytocom=
# Открываем статику: закрывать CSS/JS запрещено
Allow: /*.css
Allow: /*.js
Allow: /*.woff2
Allow: /images/
# --- Яндекс ---
User-agent: Yandex
Disallow: /cart/
Disallow: /checkout/
Disallow: /personal/
Disallow: /admin/
Disallow: /api/
Disallow: /search?
Disallow: /*?utm_
Disallow: /*?sort_by=
Disallow: /*?price_from=
# Crawl-delay понимает только Яндекс. Ставьте только если сервер реально перегружен.
Crawl-delay: 1

# --- Все прочие поисковые агенты ---
User-agent: *
Disallow: /admin/
Disallow: /api/
Disallow: /cart/
Disallow: /checkout/
Disallow: /personal/
Disallow: /search?
# --- AI-краулеры: не влияют на поиск, но экономят ресурсы сервера ---
User-agent: GPTBot
Disallow: /
User-agent: ClaudeBot
Disallow: /
# Карта сайта — одна строка на каждый файл карты
Sitemap: https://example.com/sitemap_index.xml
Что можно закрывать: корзину, оформление заказа, личный кабинет, админку, служебные API, внутреннюю выдачу поиска, параметрические хвосты фильтрации и сортировки, технические песочницы и staging-поддомены.
Что закрывать нельзя:
- CSS, JS, шрифты — с 2019 года поисковики требуют开放 статики для корректного рендеринга. Закрытие ломает оценку мобильности и может привести к ошибочному снятию страниц с индексации.
- Страницы, которые нужно удалить из индекса: Disallow мешает боту увидеть тег noindex. Получается обратный эффект — URL остаётся в выдаче без описания.
- Страницы, на которых развешан canonical на основной URL: закрытый от обхода дубль не передаст подсказку, и склейка не сработает.
- Фавиконки и изображения, участвующие в картиночной выдаче.
Устаревшие и запрещённые директивы
- Noindex: в robots.txt — не поддерживается Google с 2019 года. Рабочие варианты: мета-тег, HTTP-заголовок X-Robots-Tag, статус 410.
- Host: — не используется Яндексом, не влияет на склейка зеркал. Удаляйте из шаблонов.
- Clean-param: — устарела, параметры убираются через canonical и Disallow.
- Crawl-delay — игнорируется Google; Яндекс читает, но злоупотребление замедляет обход вашего же сайта.
- Disallow: /*.css$ и /*.js$ — антипаттерн, ломающий рендеринг.
- Disallow: / на рабочем домене — фатальная ошибка; проверяйте robots.txt в списке обязательных шагов перед выкаткой прод-релиза.
Как закрыть страницы от индексации: три способа и когда какой
- Мета-тег <meta name=»robots» content=»noindex,follow»> — когда страница нужна пользователям и должна передавать вес по ссылкам. Страница остаётся доступной для обхода, поэтому сигнал доходит.
- HTTP-заголовок X-Robots-Tag: noindex — для PDF, изображений, выгрузки API и тех случаев, когда править HTML нельзя. Самый надёжный способ для не-HTML ресурсов.
- Статус 410 — когда документа нет и не будет. Самый быстрый путь к удалению из индекса.
Disallow не удаляет страницу из индекса. Для удаления нужны noindex, X-Robots-Tag или 410. Закрытие в robots.txt лишь лишает вас возможности показать поисковику эти сигналы.
Sitemap.xml: правила генерации, лимиты и как ускорить индексацию новых страниц
Лимиты, форматы и структура карты
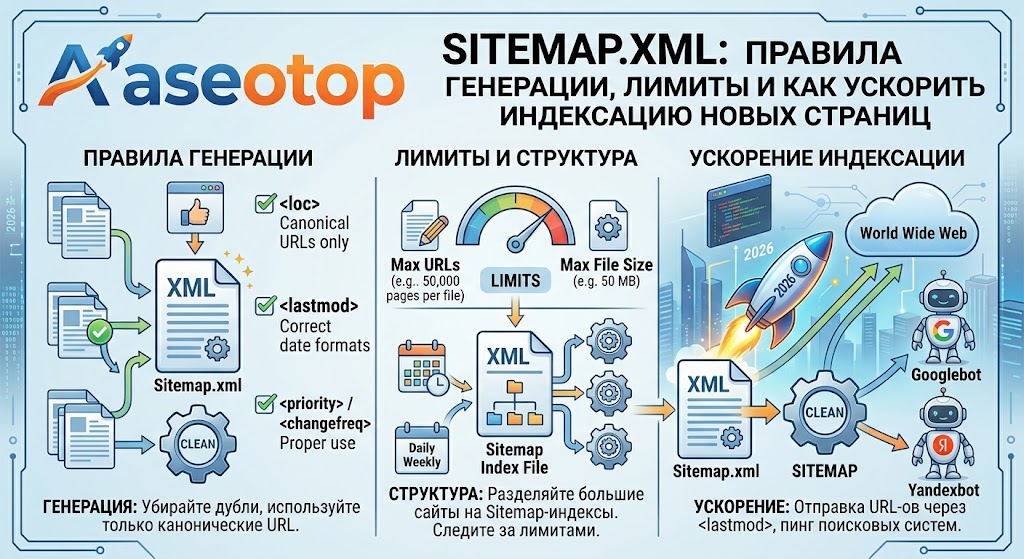
- Один файл: максимум 50 000 URL или 50 МБ в несжатом виде — что наступит раньше.
- Индекс карты (sitemapindex): до 50 000 дочерних файлов. Для каталогов от 100 000 URL — только индекс с разбивкой по типам: товары, категории, статьи, медиа.
- Сжатие gzip обязательно: экономия трафика и ускорение отдачи. Отдавайте Content-Type: application/sitemap+xml или text/xml, статус 200.
- В карте — только канонические URL со статусом 200. Никаких 301, 404, noindex, закрытых в robots.txt.
- <priority> и <changefreq> Google не использует. Разметка с ними — мусор, который увеличивает размер файла.
lastmod: единственная директива, которая реально ускоряет обнаружение
Формат — W3C DT: 2026-10-13 или с точностью до секунды и часовым поясом 2026-10-13T09:41:00+03:00. Требование одно: lastmod должен меняться только при содержательном изменении документа. Если генератор проставляет текущую дату всем URL при каждой сборке — поисковик перестаёт доверять полю, и карта деградирует до простого списка адресов.
Правильная логика: lastmod = дата последнего изменения поля контента в базе (updated_at), а не дата сборки карты. Для каталога: изменение цены без изменения описания — не повод обновлять lastmod, если вы не хотите потерять доверие к полю.
Sitemap xml генератор: штатный, плагиновый или собственный
- Штатный генератор CMS подходит до 10 000–20 000 URL. Дальше начинаются проблемы: полная пересборка, отсутствие инкрементального обновления, отсутствие честного lastmod.
- Плагины дают разбивку по типам и очередь обновления, но часто тащат в карту служебные URL иarchive-разметку. Проверяйте выгрузку выборочно, а не на глаз.
- Собственный sitemap xml генератор нужен от 50 000 URL: инкрементальная сборка по событию изменения документа, отдача через кэш (Redis/Memcached) с TTL 5–15 минут, отдельный генератор для товаров с разбивкой по категориям. Сборка — в фоне, не в пользовательском запросе.
Восемь ошибок, из-за которых карту игнорируют
- lastmod = дата сборки для всех URL.
- В карте — редиректы и 404: снижается доверие ко всему файлу.
- Карта закрыта в robots.txt или отдаёт 403.
- Один файл на 400 000 URL без разбивки: превышение лимита, обрезка, потеря хвоста.
- Абсолютные URL с зеркалом (http, www) вместо основного протокола.
- Отсутствие ссылки на карту в robots.txt при том, что карта есть.
- Кодировка не UTF-8 и неэкранированные & в параметрах URL.
- Генерация в пользовательском запросе: карта отдаётся 12 секунд, бот уходит по таймауту.
Тот самый кейс с каталогом, о котором я говорил во вступлении, закрылся именно здесь: переписали генерацию на инкрементальную с честным lastmod по updated_at, закрыли параметрические фильтры от обхода, повесили self-canonical на карточки с UTM-метками. Время появления нового товара в выдаче сократилось с двух недель до двух часов. Контент не менялся ни символа.
Дубли страниц и атрибут canonical: как найти зеркала и правильно их склеить
Canonical: что это и как поисковик читает подсказку
Canonical — это HTML-элемент или HTTP-заголовок, указывающий основной URL для набора копий. Формат — абсолютный адрес, один на страницу, в <head>:
<link rel="canonical" href="https://example.com/product/krovlya-profi-n12/" />Ключевое: это подсказка, а не команда. Поисковик сверяет её с редиректами, содержимым, внутренними ссылками и историей URL. При конфликте победит тот URL, который кажется системе основным. Canonical игнорируется, если указанный адрес отдаёт 404, закрыт в robots.txt, несёт noindex или содержит существенно другой контент.
- Не комбинируйте canonical и noindex на одной странице: noindex отменяет смысл подсказки.
- Каждая страница пагинации получает self-canonical. Разметка rel=»prev»/»next» не используется Google с 2019 года.
- Кросс-доменный canonical работает, но применяйте его только при реальном переносе или дублировании контента между своими доменами.
- Для PDF и изображений — canonical в HTTP-заголовке Link.
Типы дублей и правильный инструмент для каждого
- Протокольные и поддоменные зеркала (http/https, www, m.) — 301 на основной хост, все варианты, включая вложенные пути.
- Слэш и регистр: /page и /page/ — одно Canonical-решение на уровне сервера, 301.
- Параметры сортировки, фильтрации, пагинации — self-canonical с отсечением параметров + Disallow в robots.txt.
- UTM- и трек-хвосты — self-canonical на чистый URL; закрывать их Disallow бессмысленно, если ссылка может прийти извне.
- Печатные версии и AMP-подобные варианты — canonical с печатной на основную.
- Товарные карточки в нескольких категориях — один основной URL, остальные — canonical на него.
- Служебные страницы (корзина, поиск по сайту, кабинет) — noindex,follow + Disallow.
- Удалённые документы — 410.
Поиск дублей в Screaming Frog: пошагово
- Configuration → Spider: Limit — 20 000–100 000 для начала; включите Follow Redirects и Crawl All Subdomains, чтобы увидеть зеркала.
- Configuration → Robots.txt → Ignore: иначе аудит упрётся в собственные ограничения файла.
- Configuration → URL Parameters: поставьте Ignore для сортировки и фильтрации — иначе половина выгрузки будет параметрическим мусором.
- Configuration → Crawl Configuration: включите сбор Canonical, Page Titles, Meta Descriptions, Word Count.
- Include/Exclude: отсекайте /admin, /api, staging-поддомены, чтобы не жечь время на служебное.
- Запуск. После — вкладка «Canonical»: фильтр Status Code ≠ 200 и столбец Canonical ≠ self. Это список битых подсказок.
- Report → Duplicates: Exact Duplicates и Near Duplicates по контенту; отдельно Duplicate Page Titles и Duplicate Meta Descriptions.
- Сортировка по Word Count по возрастанию: тонкие страницы, которые нужно либо усиливать, либо закрывать.
- Internal → Orphan Pages: страницы без внутренних ссылок. Они не получают вес и почти не посещаются краулером.
- Экспорт: Bulk Export → Canonical + Response Codes, сводите в таблицу с колонками «URL / Canonical / Status / Word Count / Inlinks» и проставляйте решение по каждой группе.
Параллельно сверяйтесь сSearch Console: отчёт «Индексирование → Страницы», статус «Дубли, Google выбрал другой canonical» — прямой сигнал, что ваша подсказка проиграла. В Яндекс.Вебмастере смотрите раздел по дублям и закрывайте расхождения по тем же правилам.
Canonical или 301: матрица решений
- URL не нужен людям и поиску, но на него ведут внешние ссылки → 301 на основной.
- URL нужен людям (фильтр, UTM-посадка, печатная версия), но не должен индексироваться → self-или основной canonical, плюс Disallow для параметров.
- Документ удалён навсегда → 410, без редиректа на главную.
- Служебная страница с полезными исходящими ссылками → noindex,follow.
- Служебная страница без ссылок → noindex + Disallow.
Редирект всех удалённых страниц на главную — ошибка: поисковик классифицирует такой ответ как мягкую 404, и вес ссылок не перетекает. Редирект оправдан только на содержательно ближайший аналог.
Коды ответов сервера (200, 301, 302, 404, 5xx): как обрабатывать ошибки и настраивать редиректы
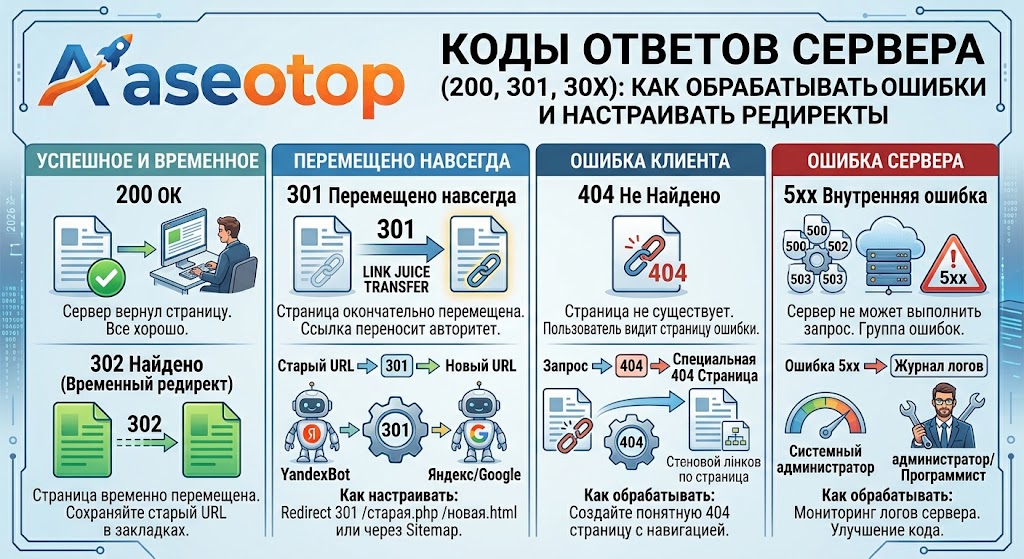
Таблица кодов ответов и их SEO-значение
| Код | Что означает | Как использовать в SEO |
|---|---|---|
| 200 | Успешный ответ, документ отдан | Норма для всех индексируемых канонических URL. Следите, чтобы за 200 не скрывался пустой контент (soft 404). |
| 204 | Успех без тела ответа | Только для API. Никогда не отдавайте 204 на HTML-страницы: краулер не получает контента. |
| 301 | Постоянный редирект | Основной инструмент склейки: смена адреса, перенос на HTTPS, склейка зеркал,合并 разделов. Передаёт сигналы основного URL. |
| 302 | Временный редирект | Технические работы на коротком отрезке. При длительном висении поисковик трактует его как постоянный — не рассчитывайте на «временность». |
| 304 | Не изменено (кэш) | Экономит трафик и время ответа. Полезно для краулинга, но проверьте корректность заголовков ETag/Last-Modified. |
| 307 / 308 | Временный / постоянный редирект с сохранением метода | 308 — для POST-сценариев и строгих миграций, где важно не потерять метод запроса. |
| 400 / 401 / 403 | Ошибка запроса / нужна авторизация / доступ запрещён | ЧастаяTechnical-проблема: закрытый WAF или CDN отдаёт 403 краулеру. Проверяйте по логам, что User-agent поисковиков не под блокировкой. |
| 404 | Не найдено | Честный ответ для несуществующего документа. Не редиректите на главную: это мягкая 404 и потеря ссылочного веса. |
| 410 | Удалено навсегда | Предпочтительный код для ликвидированных товаров и статей: из индекса такие URL уходят быстрее, чем по 404. |
| 429 | Слишком много запросов | Если отдаёте 429 краулеру — теряете обход. Для ботов лимиты не применяйте или делайте исключение по User-agent и IP-диапазонам. |
| 500 | Внутренняя ошибка сервера | Сигнал нездоровья. Растущая доля 500 снижает частоту обхода. Чаще всего это не SEO-проблема, а проблема конфигурации PHP/БД. |
| 502 / 504 | Плохой шлюз / таймаут шлюза | Обычно следствие перегруза бэкенда или малого таймаута прокси. Краулер уходит, страница не обновляется в индексе. |
| 503 | Сервис недоступен | Единственный корректный код на время регламентных работ. Обязателен заголовок Retry-After, иначе поисковик начнёт исключать страницы. |
Ошибка 404: как исправить и не потерять вес ссылок
- Соберите список: Search Console → «Индексирование → Страницы → Не найдено», плюс выгрузка из логов сервера по статусу 404 с группировкой по Referer. Реферер покажет, откуда приходят битые ссылки: внутренние, внешние или рекламные.
- Разбейте на три группы: удалённый контент, опечатки в перелинковке, битые внешние ссылки.
- Удалённое с живым аналогом → 301 на ближайший по смыслу раздел или карточку.
- Удалённое без аналога → 410 и удаление ссылки из меню и карты сайта.
- Опечатки в внутренней перелинковке → правка источника, а не костыль в виде редиректа. Редирект на опечатку живёт годами и копится в базе.
- Проверьте, что CMS не отдаёт 200 на несуществующие адреса: типичный баг шаблона 404, из-за которого индекс разрастается мусором.
Ошибка 500 на сайте: диагностика за 15 минут
- Логи: Nginx error.log, Apache error_log, PHP-FPM slow.log. Ищите не «ошибка», а первый по времени сбой — остальные часто его следствие.
- Типовые причины: исчерпание memory_limit, упирающийся max_execution_time (по умолчанию 30 с), переполненный пул PHP-FPM (pm.max_children), тяжёлый запрос к БД без индекса, конфликт плагина после обновления, переполненный диск или исчерпание inode.
- Проверьте, не отдаёт ли WAF/CDN 5xx вместо бэкенда: сравните ответ с сервера напрямую и через прокси.
- Не путайте с мягкими ошибками: если CMS отдаёт 500 вместо 404 на несуществующие URL, поисковик продолжит возвращаться к мёртвым адресам и не удалит их из индекса.
- Порог тревоги: устойчивая доля 5xx выше 1–2% от запросов краулера. Выше — обход режут, и свежий контент перестает попадать в выдачу вовремя.
Правила редиректов, которые нельзя нарушать
- Один хоп. Цепочка из двух и более редиректов проходит не всегда, а каждый хоп — лишний запрос из вашего бюджета.
- Никаких циклов: A → B → A приводит к тому, что обе страницы выпадают из индекса.
- Не редиректите на 404 и не редиректите на главную.
- HTTPS-редирект настраивайте на уровне сервера, до приложения: быстрее и не зависит от CMS.
- При переносе структуры сохраняйте соответствие «старая страница → содержательный аналог», а не «раздел → раздел».
Скорость загрузки сайта и Core Web Vitals: что критично для ранжирования сегодня
Пороговые значения Core Web Vitals в 2026 году
Измерение — по 75-му перцентиле реальных пользователей (CrUX / RUM), отдельно для мобильных и десктопных сессий. Полевые данные приоритетнее лабораторных.
- LCP — Largest Contentful Paint: хорошо до 2.5 с, плохо свыше 4.0 с.
- INP — Interaction to Next Paint: хорошо до 200 мс, плохо свыше 500 мс. Сменил FID в 2024 году и измеряет отзывчивость на все взаимодействия, а не только первый клик.
- CLS — Cumulative Layout Shift: хорошо до 0.1, плохо свыше 0.25.
- TTFB — время до первого байта: ориентир до 800 мс, рабочая цель 200–300 мс. Это не метрика CWV, но именно она определяет, сколько запросов в секунду выдержит ваш хост.
Что чинить первым: порядок по влиянию
- LCP: предзагрузка главного изображения через <link rel=»preload» as=»image»>, критический CSS инлайн, удаление render-blocking ресурсов, WebP/AVIF с весом файла до 200 КБ для геро-блока, HTTP/2 или HTTP/3, CDN ближе к аудитории. Чаще всего LCP чинится одним изображением и одним CSS.
- INP: декомпозиция длинных задач JavaScript до отрезков менее 50 мс, отказ от синхронных блокирующих скриптов, defer для всего некритичного, аудит сторонних тегов — аналитика, чаты, ретаргетинг дают основную часть задержек.
- CLS: явные width/height у изображений и видео, font-display: optional или предзагрузка шрифтов, зарезервированные блоки под рекламные и динамические вставки.
- Сервер: кэш страниц, оптимизация медленных запросов, добавление недостающих индексов в БД, отключение тяжёлых плагинов, которые собирают страницу на каждый запрос.
Скорость ответа сервера и обход: прямая связь
Здесь две независимые истории, которые часто смешивают. На ранжирование метрики CWV влияют умеренно и в связке с остальными сигналами. На обход они влияют напрямую и сильно: чем дольше сервер держит соединение, тем меньше запросов в секунду поисковик готов делать. Увеличение TTFB с 200 мс до 1.5 с на крупном каталоге сокращает суточный объём обхода в разы — и это выражается не в «позициях», а в том, что новые страницы появляются в выдаче через дни вместо часов. Узнайте: сбой в работе Яндекс Директа, Метрики, Вебмастера, что делать пошаговая инструкция.
Оптимизация скорости на большом сайте окупается прежде всего в скорости обновления индекса, а уже потом в позициях.

Финальный чек-лист: технический аудит сайта перед сдачей клиенту или запуском (20 пунктов)
Чек-лист: 20 пунктов
- Одно зеркало отдаёт 200, все остальные — 301 на основной протокол и хост, включая вложенные пути.
- robots.txt отдаёт 200, размер менее 500 KiB, нет запрещённых директив, CSS/JS/шрифты открыты.
- В robots.txt закрыты корзина, кабинет, админка, внутренняя выдача, параметры сортировки и фильтрации.
- Нет директив Noindex и Host в robots.txt; Crawl-delay стоит только при реальной перегрузке сервера.
- Staging и тестовые поддомены закрыты от индексации на уровне заголовков, а не только robots.txt.
- Карта сайта разбита на файлы до 50 000 URL, сжата, отдаёт 200, указана в robots.txt.
- В карте только канонические URL со статусом 200, без редиректов, 404 и noindex.
- lastmod отражает реальное изменение документа, а не дату сборки карты.
- Каждая страница содержит ровно один canonical, абсолютный, указывающий на адресуемый URL со статусом 200.
- Пагинация — self-canonical на каждой странице, без разметки prev/next.
- Карточки с UTM- и трек-хвостами отдают self-canonical на чистый URL.
- Нет канонических подсказок, указывающих на закрытые, noindex или 404-страницы.
- Цепочки редиректов отсутствуют: максимум один хоп, циклов нет.
- Удалённые документы отдают 410, а не 200 и не редирект на главную.
- Нет мягких 404: шаблон «не найдено» отдаёт корректный код, а не 200.
- Доля 5xx в логах краулера ниже 1%, при регламентных работах отдаётся 503 с Retry-After.
- WAF и CDN не блокируют пользовательские агенты поисковых систем, исключены их IP-диапазоны.
- Скорость: LCP до 2.5 с, INP до 200 мс, CLS до 0.1 на 75-м перцентиле, TTFB в пределах 200–300 мс на кэшируемых страницах.
- Критичный контент, заголовки и перелинковка присутствуют в исходном HTML, а не только после выполнения JavaScript.
- Нет осиротевших страниц: каждая индексируемая страница имеет минимум одну внутреннюю ссылку из значимого раздела.
Формат отчёта
Выдавайте аудит таблицей: «Проблема / Затронутые URL / Код ответа / Решение / Ожидаемый эффект / Приоритет». Без количества затронутых URL заказчик не поймёт масштаб, а без приоритета команда разработки начнёт с самого простого, а не с самого дорогого. Первыми в работе — пункты, влияющие на обход: зеркала, 5xx, параметрические дубли, скорость ответа. Они дают измеримый сдвиг за 2–4 недели.
За два десятилетия разборов у меня сложился один вывод, и он не про тексты: видимость ломают механика и дисциплина. Закрытая краулеру директория и десятки тысяч копий, выевших лимит обхода, обесценивают любую редакционную работу — и наоборот, наведение порядка в карте, редиректах и канонических адресах возвращает сайту способность обновляться в срок. Начните с технического слоя, закройте чек-лист целиком, и остальное начнёт работать заметно быстрее, чем вы ожидаете.


